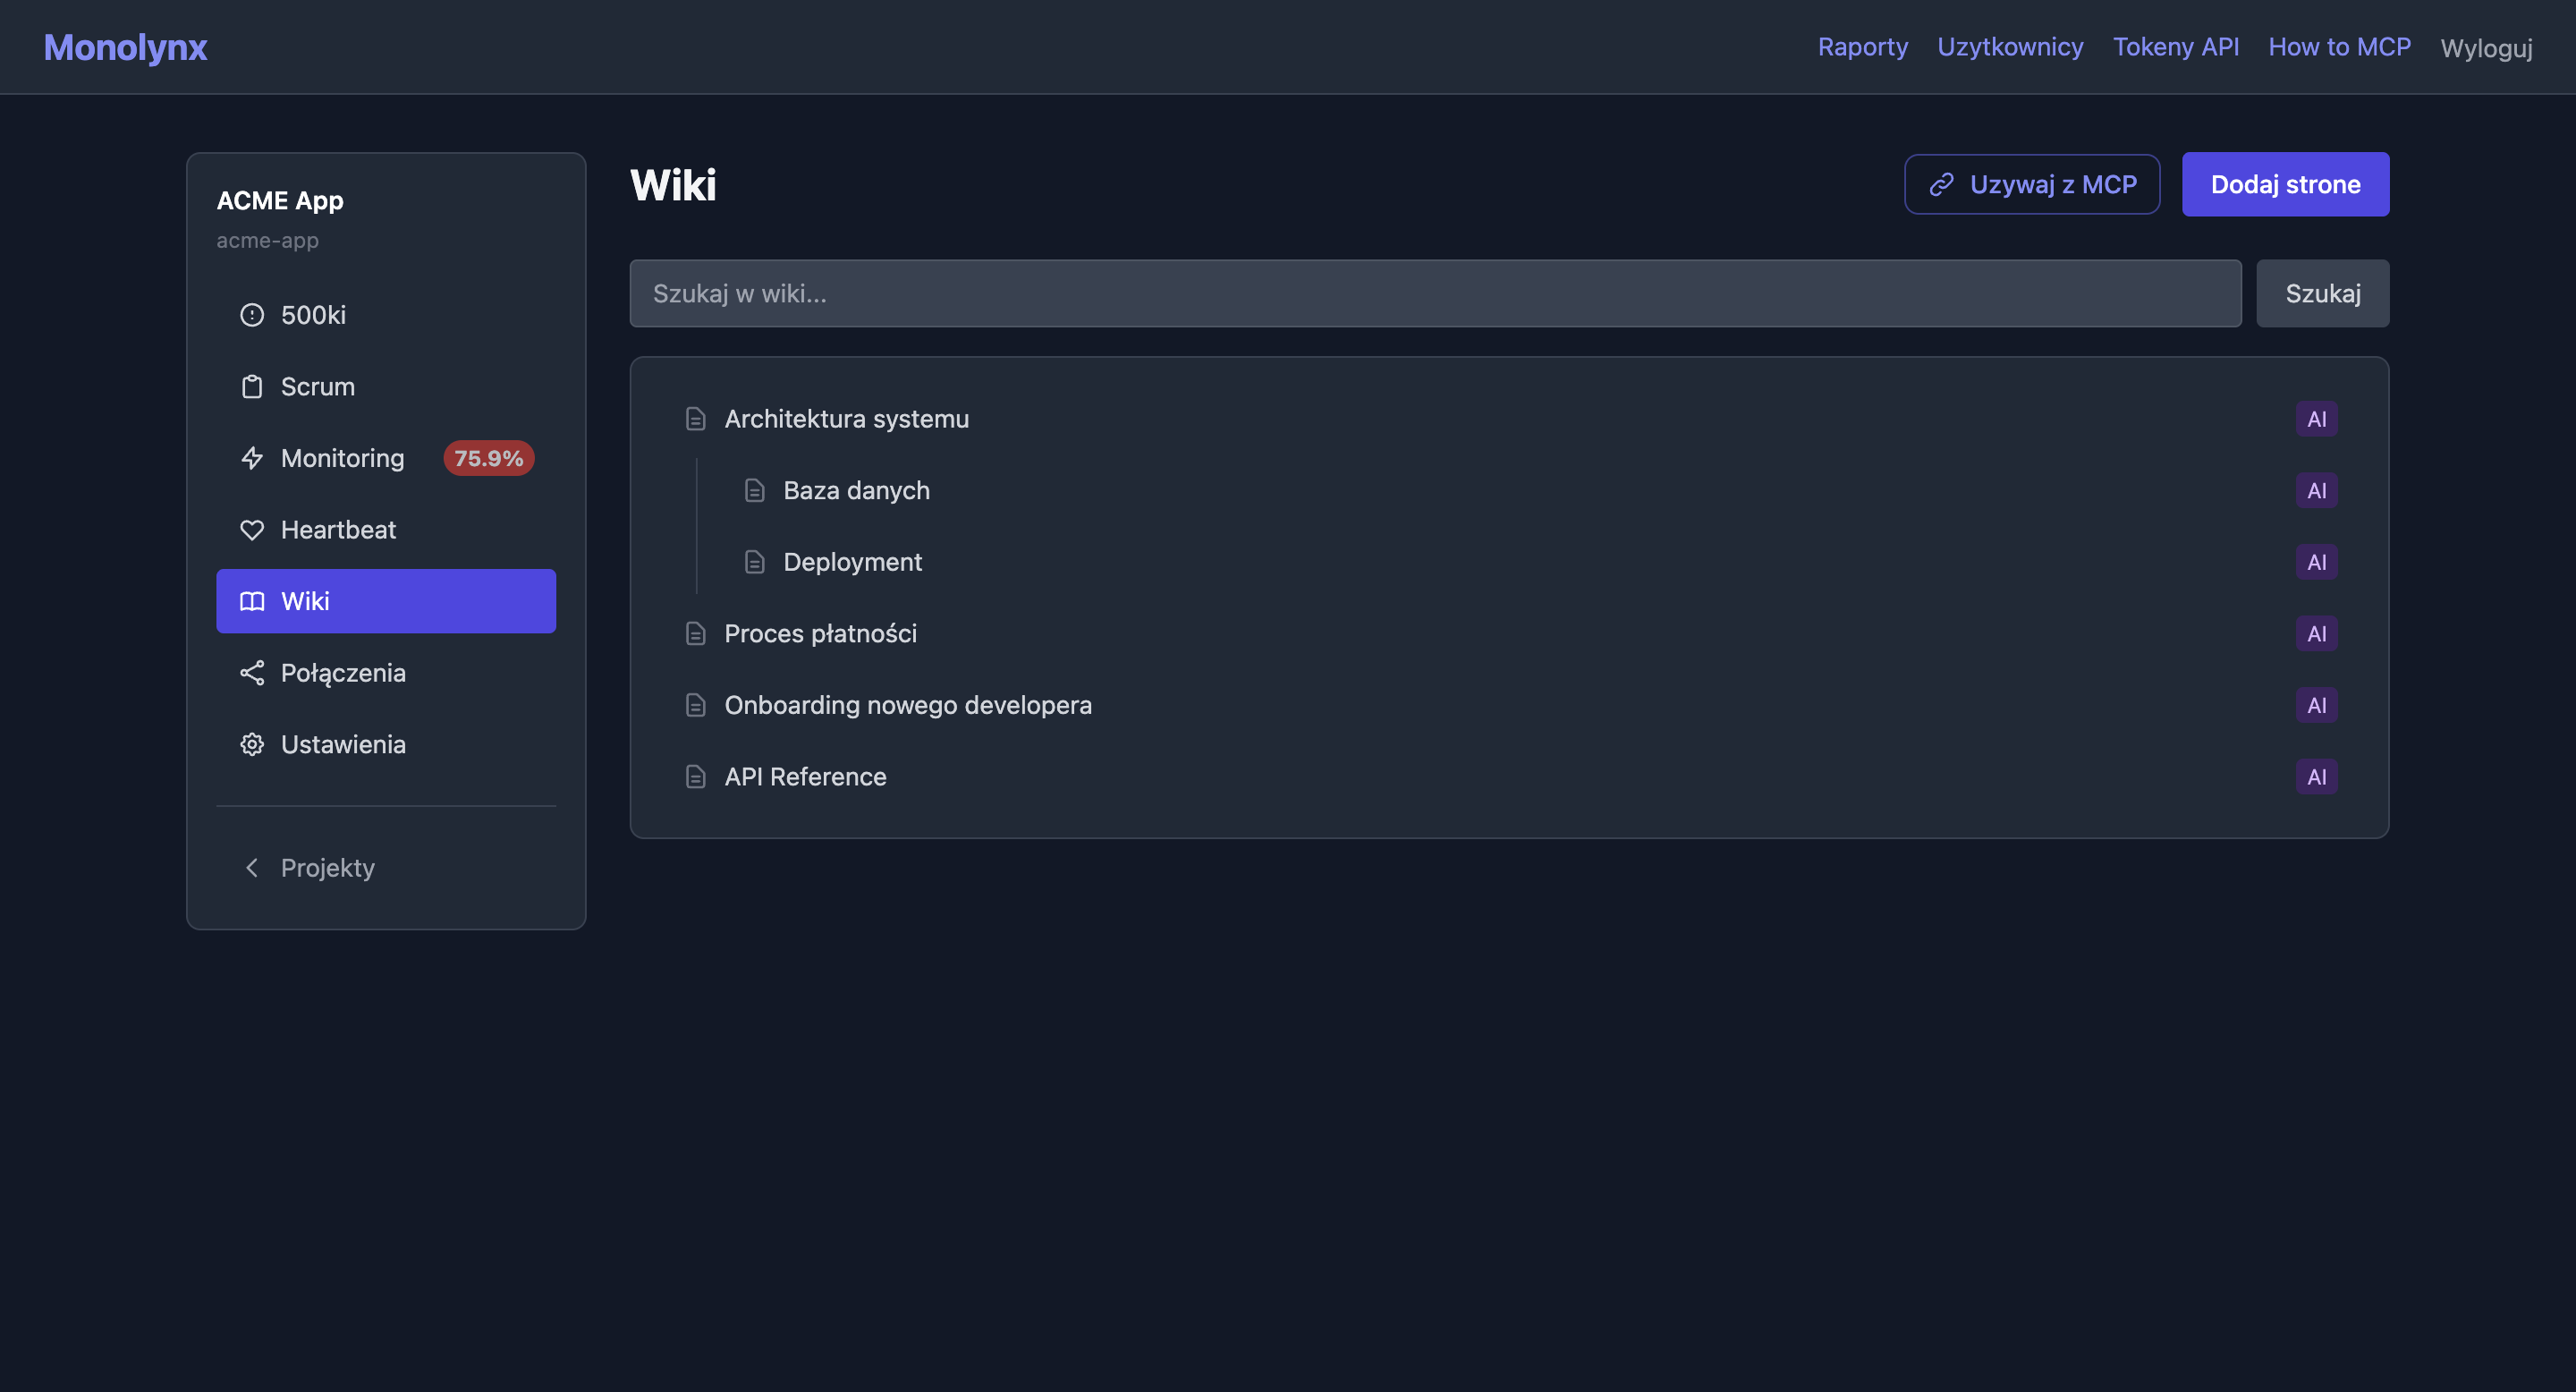
Hierarchiczne strony Markdown z edytorem WYSIWYG, uploadem obrazów do MinIO i wyszukiwaniem semantycznym przez pgvector + OpenAI embeddings. To wiki zaprojektowane dla ludzi i agentów AI jednocześnie.
Drzewo stron z relacją parent/child. Breadcrumby do nawigacji. Podstrony wyświetlane na stronie rodzica.
Markdown z podglądem na żywo, formatowaniem i wstawianiem obrazów przez drag & drop. Dark theme dopasowany do UI.
Obrazy przechowywane w object storage (MinIO). Ścieżka: {slug}/attachments/{filename}. Serwowane bezpośrednio.
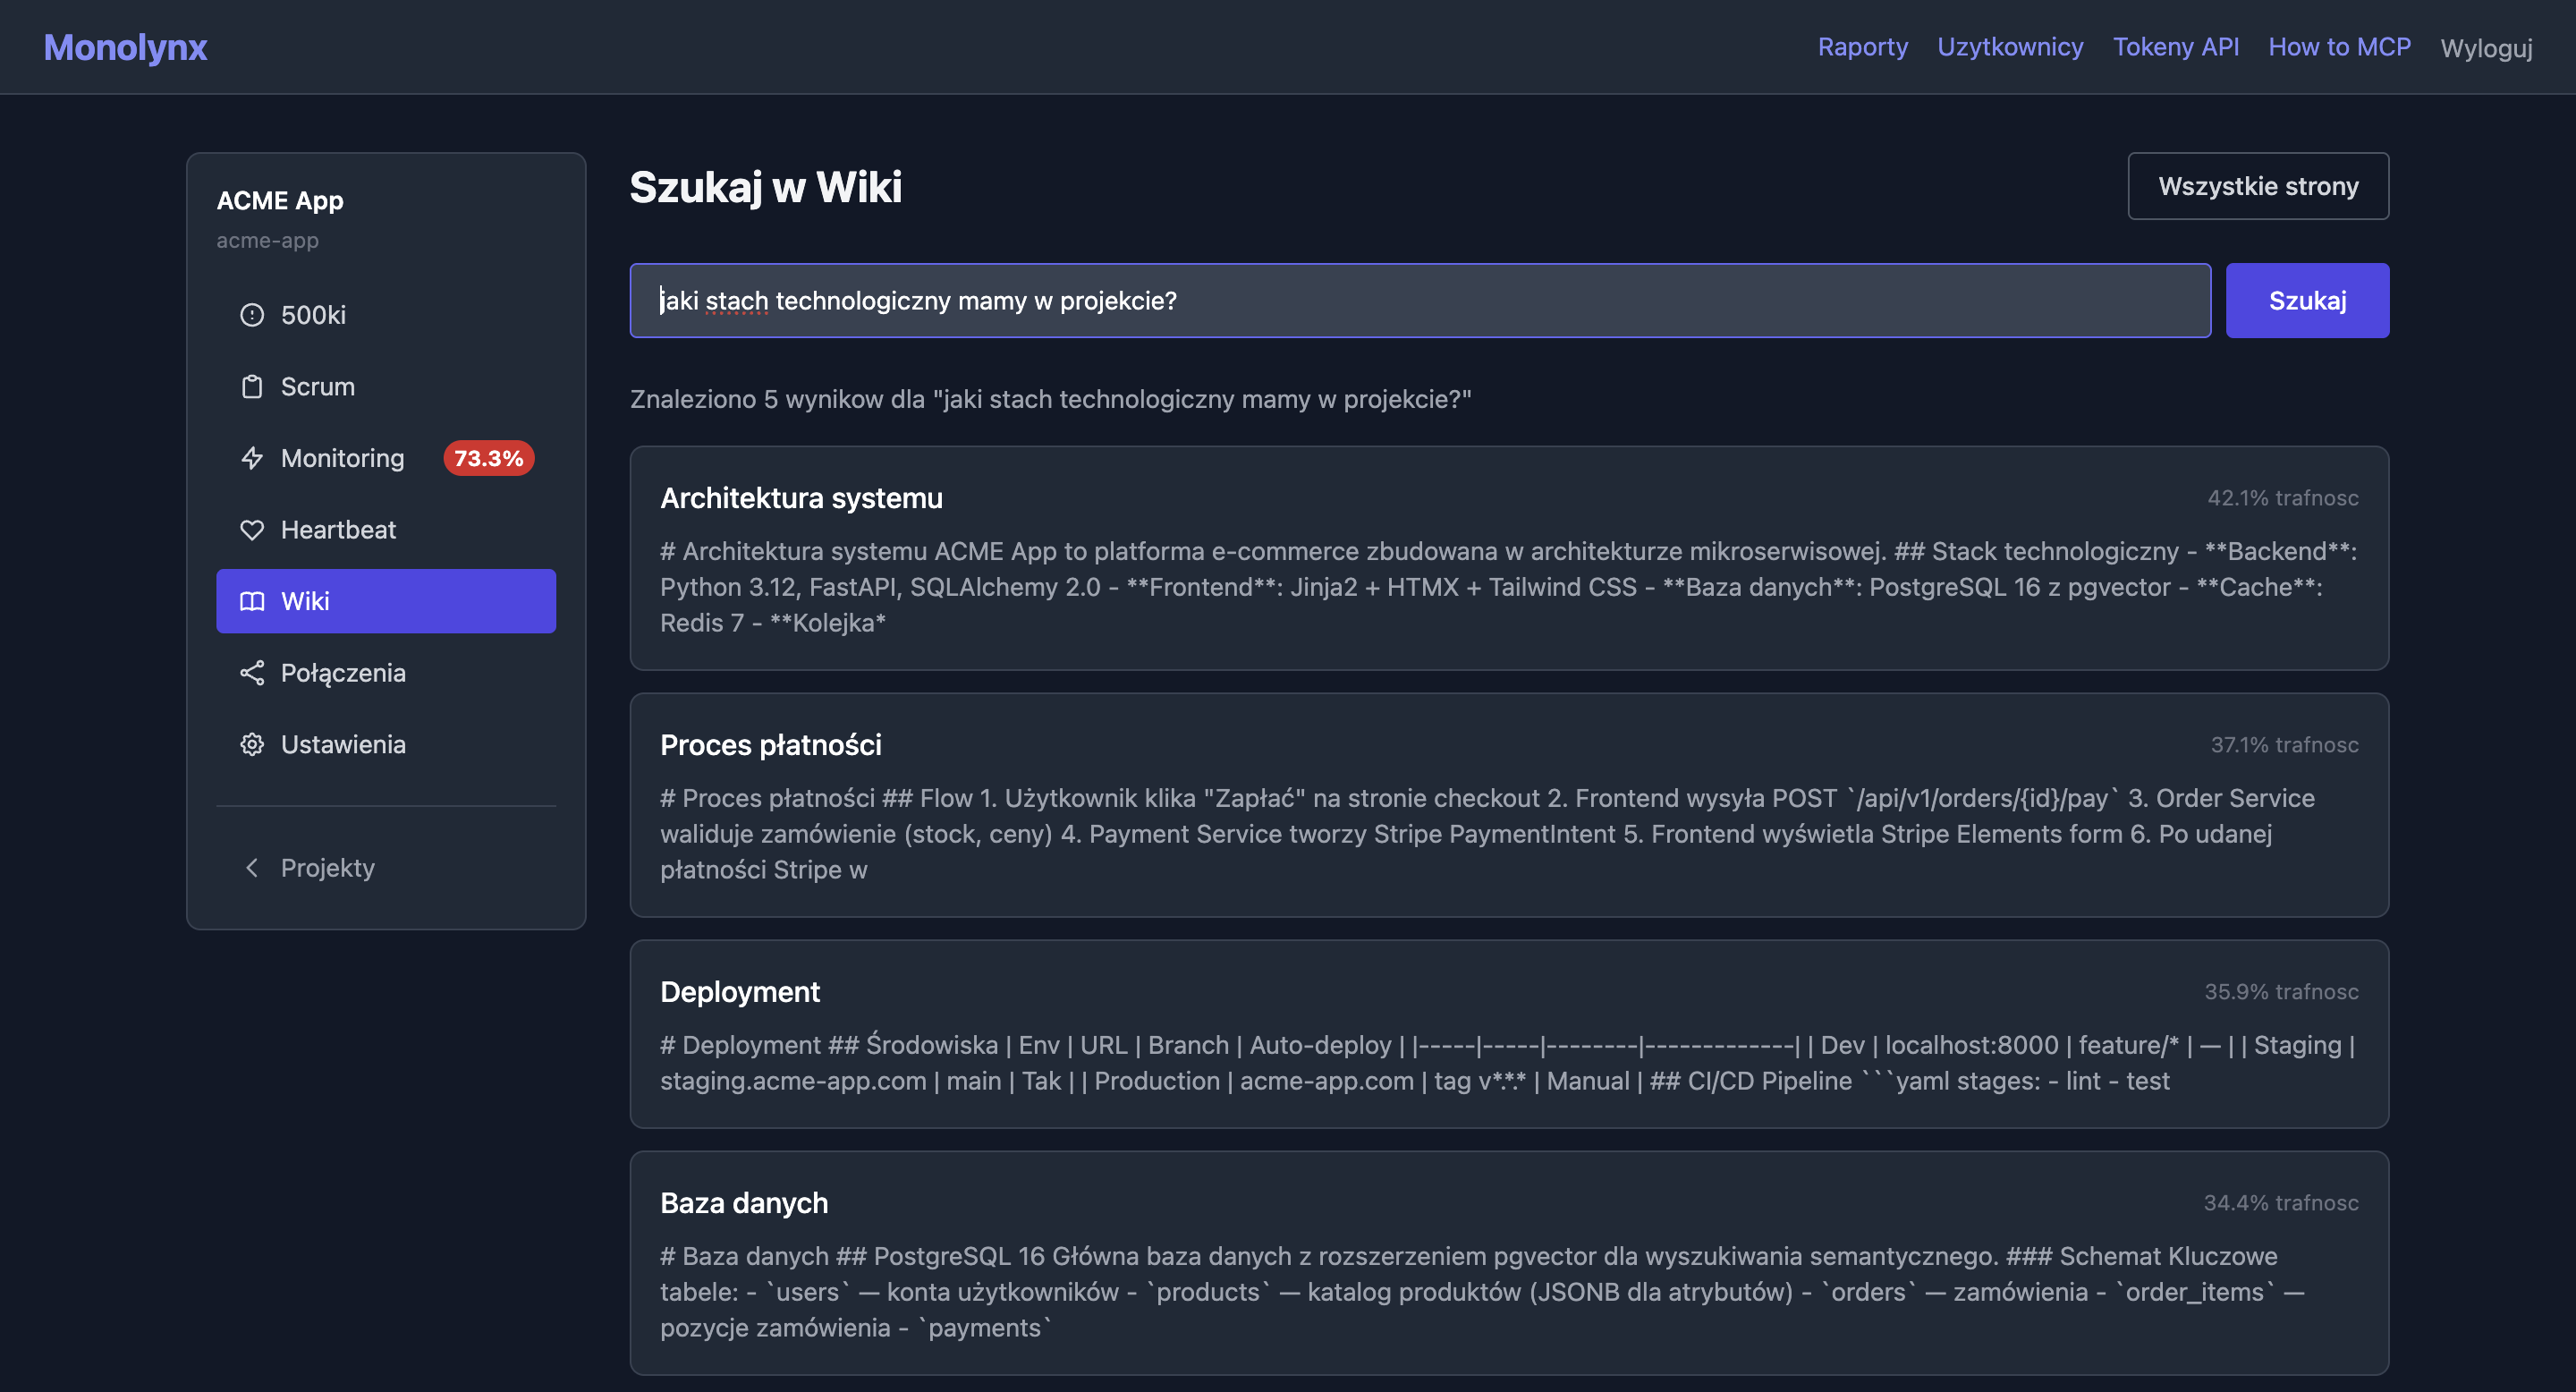
pgvector z HNSW index + OpenAI text-embedding-3-small. Pytasz naturalnym językiem — system znajduje najlepiej pasujące fragmenty.
Strony dzielone na fragmenty ~500 tokenów z nakładaniem się. Tokenizacja przez tiktoken. Każdy chunk ma osobny embedding.
Kto utworzył stronę, kto ostatnio edytował. Pełna przejrzystość zmian.
Brak klucza OpenAI? Wiki działa normalnie — wyszukiwanie semantyczne jest po prostu wyłączone.
render_markdown_html() z Tailwind prose prose-invert. Ten sam renderer używany w ticketach i komentarzach Scrum.
Checkbox „strona publiczna” w formularzu wiki wystawia treść bez logowania pod /blog/{slug}. Zmienia go tylko konto z uprawnieniem do edycji bloga, które nadaje superuser; pozostałe konta widzą stan strony bez możliwości zmiany. Załączniki wpisu (obrazy, PDF) serwowane bezpiecznie — allow-lista MIME dla inline (PNG/JPEG/GIF/WebP), reszta jako attachment z nagłówkiem X-Content-Type-Options: nosniff.
Adres wpisu nie zmienia się po zmianie tytułu strony, a poprzedni adres przekierowuje (301) na aktualny. Lista /blog/ sortuje wpisy po dacie publikacji, więc edycja starszego wpisu nie przestawia kolejności. Zajawka na liście i opis w meta pochodzą z opisu wpisu, a gdy go brak - ze streszczenia treści.
Wpis piszesz zwykłym markdownem, a strona dostaje gotowe bloki: wyróżnienia (uwaga, wskazówka, ostrzeżenie) i TL;DR, cytat z autorem, obrazek z podpisem, kod z nazwą pliku i przyciskiem kopiowania, kotwice nagłówków oraz przypisy. HTML bloków generuje serwer, a treść autora jest sanityzowana, więc własne skrypty, klasy i identyfikatory nie trafią na stronę.
Kilka linii markdownu wystarczy, żeby wpis dostał FAQ w formie akordeonu, kroki, statystyki, tabelę porównawczą z wyróżnioną kolumną, sekcję zwijaną, galerię, przycisk CTA i słownik pojęć. Wideo z YouTube i Vimeo ładuje się dopiero po kliknięciu, więc wcześniej strona nie wysyła żadnych żądań do serwisu wideo. Z FAQ, kroków i wideo serwer przygotowuje dane strukturalne dla wyszukiwarek i modeli AI.
Tabela markdown staje się wykresem słupkowym, liniowym albo kołowym, który serwer rysuje jako SVG, opis z kodem Mermaid staje się diagramem, a blok konsoli oknem terminala z animacją pisania. Animowane schematy pochodzą z zamkniętej listy komponentów w repozytorium, więc treść wpisu nie zawiera skryptów ani stylów. Źródłem każdej grafiki jest tekst: dane, opis albo kod widzi model AI w wersji markdown i czytelnik z wyłączonym JS. Wykresy i schematy działają w jasnym i ciemnym motywie, a animacje wyłączają się przy ograniczeniu ruchu w systemie.
Wpis ma nagłówek z tagami, autorem, datami, czasem czytania i okładką oraz spis treści z nagłówków H2-H3, który podświetla bieżącą sekcję (od 3 nagłówków). Pod treścią są linki do wersji językowych i do 3 powiązanych wpisów w tym samym języku. Listę /blog/ filtrujesz po tagu i języku (?tag=, ?lang=), a paginacja zachowuje filtry.
Blog ma feedy Atom, RSS i JSON Feed z pełną treścią 20 najnowszych wpisów, a czytniki znajdują je w nagłówku strony. Plik /llms.txt zawiera na żywo listę najnowszych wpisów z adresami markdown, a /llms-full.txt całą publiczną treść bloga w jednym dokumencie. Wersje językowe wpisów są powiązane w mapie strony, a roboty AI (GPTBot, ClaudeBot, PerplexityBot i inne) mają w robots.txt dostęp do bloga bez dostępu do panelu, API i MCP.
Lint sprawdza wpis przed publikacją: opis o długości 50-300 znaków, blok TL;DR z 2-5 punktami na początku, tekst alternatywny obrazków, treść bloków graficznych, kolejność nagłówków, opisowe teksty linków, datę weryfikacji i tłumaczenie. Wynik to lista problemów z numerem linii i poziomem (błąd, ostrzeżenie, informacja) oraz ocena 0-100. Ten sam wynik daje narzędzie MCP lint_blog_post, REST API i komenda monolynx blog lint.
Publikacja wpisu to osobna operacja: najpierw lint, potem strona staje się publiczna pod /blog/{slug}. Wpis z błędami lintu zostaje prywatny, a odmowa wymienia reguły do poprawy; parametr force publikuje mimo błędów. Cofnięcie publikacji zdejmuje wpis i jego wersję markdown z sieci (404), a data publikacji i slug zostają, więc ponowna publikacja wraca pod ten sam adres. Robią to narzędzia MCP publish_blog_post i unpublish_blog_post, REST API oraz komendy monolynx blog publish i monolynx blog unpublish. Publikacja, jej cofnięcie i zmiana metadanych wymagają uprawnienia do edycji bloga na koncie użytkownika: nadaje je wyłącznie superuser, a sama rola w projekcie, także właściciela, nie wystarcza.
Sekcja „Wpis na blogu” w formularzu edycji strony ustawia adres (slug), opis z licznikiem znaków, autora, tagi, język, powiązanie z tłumaczeniem, okładkę wybraną z załączników strony i datę weryfikacji. Błąd walidacji pokazuje komunikat i zachowuje wpisane wartości, a zwykła strona wiki z pustą sekcją nie staje się wpisem. Sekcję widzi tylko konto z uprawnieniem do edycji bloga.
Przycisk „Podgląd wpisu” na stronie wiki otwiera szkic w wyglądzie publicznego bloga, z blokami, spisem treści i czasem czytania, zanim zaznaczysz „strona publiczna”. Podgląd widzi tylko zalogowany użytkownik z prawem odczytu wiki, a jego adres ma nagłówek noindex i nie trafia do mapy strony, feedów ani /llms.txt.
Skill /monolynx:blog-post prowadzi wpis od briefu przez konspekt, szkic i lint do podglądu, a publikuje dopiero po Twojej jawnej zgodzie; w sesji w tle kończy na szkicu. Publiczny przewodnik /blog-authoring.md opisuje składnię bloków, reguły lintu i operacje connectorów, więc wpis w tym formacie napisze też model bez pluginu.
Menu „Wstaw blok” w pasku edytora wstawia w miejscu kursora gotowy szablon składni każdego bloku wpisu, a lista bloków pochodzi z rejestru na serwerze. Obrazek wgrany w edytorze zostaje załącznikiem strony i po publikacji wyświetla się czytelnikowi bez logowania.
Np. "Architektura systemu". Użyj edytora EasyMDE do pisania w Markdown.
Twórz strony-dzieci, np. "Baza danych" pod "Architekturą". Drzewo buduje się automatycznie.
Przeciągnij obrazy do edytora — automatycznie uploadują się do MinIO i wstawiają jako Markdown.
Wpisz pytanie w polu szukaj — system znajdzie najlepiej pasujące fragmenty stron na podstawie znaczenia, nie tylko słów kluczowych.
Agent AI może przeczytać dowolną stronę i wyszukać informacje semantycznie — tak jakby był członkiem zespołu.
Wiki to serce AI-first podejścia Monolynx. Agent AI przeszukuje dokumentację, zarządza załącznikami i plikami projektu - 13 narzędzi MCP.
Dostępne narzędzia MCP
list_wiki_pages
Pełne drzewo hierarchii z parent_id i głębokością
get_wiki_page
Treść strony + breadcrumby do nawigacji
create_wiki_page
Nowa strona z opcjonalnym parent_id (podstrona)
update_wiki_page
Edycja treści, tytułu, pozycji
delete_wiki_page
Usuwanie kaskadowe (strona + podstrony)
search_wiki
Wyszukiwanie semantyczne RAG (jeśli embeddingi aktywne)
add_wiki_page_attachment
Dodaj załącznik do strony wiki (base64)
list_wiki_page_attachments
Lista metadanych załączników strony (bez zawartości)
get_wiki_attachment
Pobierz zawartość załącznika strony wiki (base64)
add_wiki_file
Dodaj globalny plik do repozytorium wiki
get_wiki_file
Pobierz zawartość globalnego pliku (base64)
update_wiki_file
Zaktualizuj opis lub nazwę pliku
list_wiki_files
Lista globalnych plików w repozytorium wiki
Śledzenie błędów
Zarządzanie projektami
Monitorowanie URL
Monitoring zadań cron
Graf zależności
Analityka pracy i eksport PDF
Rozliczenia cross-project i załączniki
Osobiste planowanie cross-project
Obserwowalność pracy agentów AI
Praca z terminala
Publiczny blog dla ludzi i modeli AI
Darmowy, open source, self-hosted. Zainstaluj na swojej infrastrukturze w kilka minut.